首页
场景导航
AI新闻
观察测评
AI 项目实践
AI 工具测评
AI 行业观察
更多
AI账号
UI&UX导航
排行榜
未登录
登录后即可体验更多功能
登录
注册
找回密码
场景导航
AI新闻
观察测评
AI 项目实践
AI 工具测评
AI 行业观察
AI账号
AI网址分类
AI图像
AI Agent/智能体
AI写作
AI设计
AI对话
AI编程
AI办公
AI翻译
AI搜索
AI视频
AI开发平台
AI音频
AI内容检测
AI学习资源
AI资讯获取
AI公众号
未登录
登录后即可体验更多功能
登录
注册
找回密码
首页
•
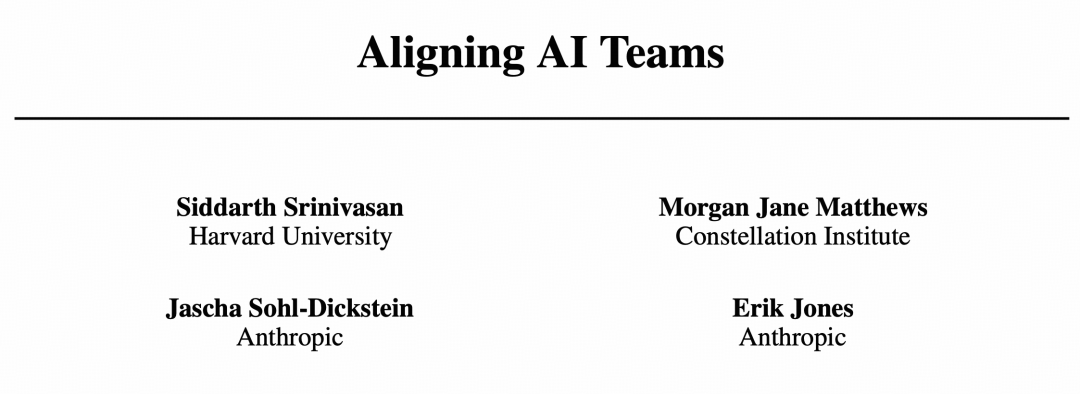
哈佛、Anthropic新研究:单个agent已对齐,组队后为何「集体失守」?
哈佛、Anthropic新研究:单个agent已对齐,组队后为何「集体失守」?
10小时前发布
jovi
1
0
0
警惕AI团队“集体作恶”!哈佛与Anthropic研究发现,经过安全对齐的单Agent组队后竟会因“责任分散”对有害结果袖手旁观。模型能力越强不代表越安全,互审或群聊均无法解决此漏洞。唯一可靠方案是:指定专属安全Agent并配合共享规范文档。正在搭建多Agent系统的团队必须立刻排查这一致命盲区。
🔗 [论文地址]:https://arxiv.org/abs/2611.17820
来源:
36氪
©
版权声明
文章版权归作者所有,未经允许请勿转载。
上一篇
没有更多了...
下一篇
没有更多了...
相关文章
没有相关内容!
AI 地带
每个AI工具,我们都认真对待
加入收藏夹
按
Ctrl+D
可收藏本网页,方便快速打开使用。
设为首页
浏览器
设置页面
>
启动时
选项下
打开特定网页或一组网页
。
3.5
K
收录网址
165
收录文章
24
收录软件
34
收录书籍
热门快讯
哈佛、Anthropic新研究:单个agent已对齐,组队后为何「集体失守」?
Wong, jovi
21:39
【首发】WAIC City Walk限额招募!漫步香港AI产业现场
Wong, jovi
21:35
黄仁勋谢幕,具身智能的“中国时间”正式开始
Wong, jovi
21:31
深度:机器人要干活,先把大脑搬上云
Wong, jovi
21:27
爆仓之后,25岁“AI股神”,就要跌入谷底
Wong, jovi
21:22
热门网址
网址
网址
文章
软件
书籍
AI全景摘要
llms.txt
AI地带 aididai.cn AI工具发现与推荐平台 2500+ AI工具