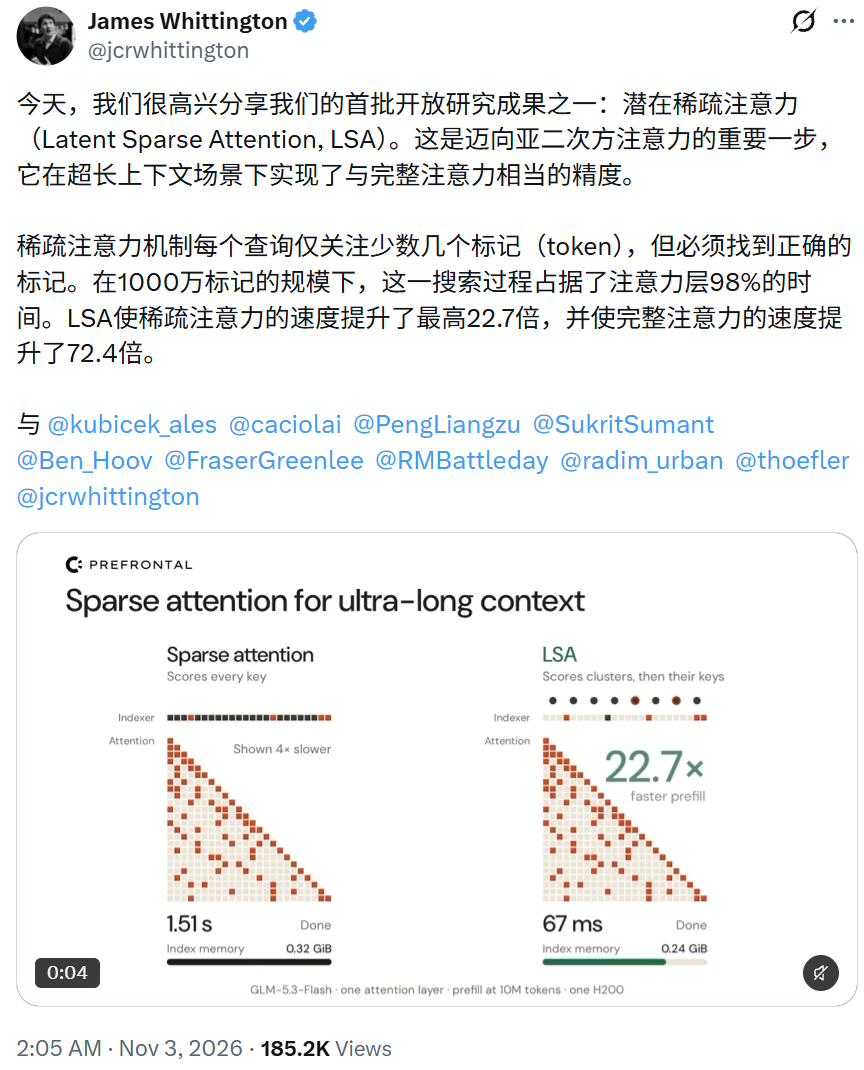
1000万token上下文不再是算力黑洞!ETH与Prefrontal AI联合提出隐空间稀疏注意力(LSA),将索引器复杂度从二次方降至次二次方。在10M token下,GLM-5.3-Flash提速22.7倍,Qwen3.8-27B狂飙72.4倍且精度不减。支持免训练蒸馏直接嫁接现有模型,这是超长文本时代的底层效率革命,AI工程师必须跟进的硬核突破。
🔗 [论文地址]:https://arxiv.org/abs/2610.42147
🔗 [GitHub项目]:https://github.com/Prefrontal-AI/latent-sparse-attention
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章
没有相关内容!
