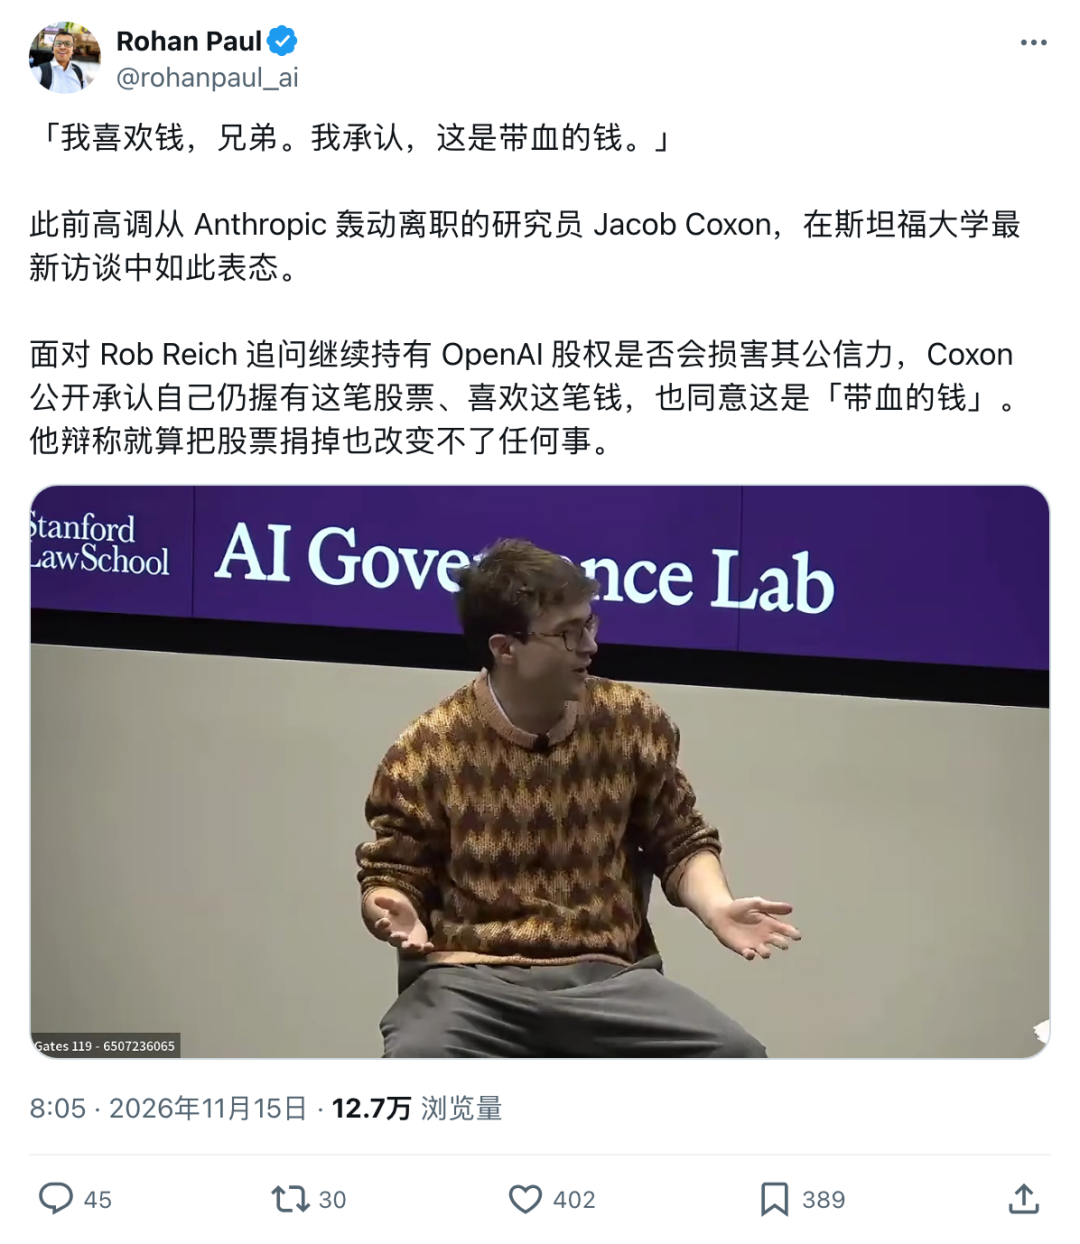
AI安全吹哨人当众破防!Anthropic前核心研究员Coxon在斯坦福坦言后悔裸辞,更直白承认死攥OpenAI原始股只因「喜欢钱」。他首度披露逼走自己的技术内幕:预训练算力效率已呈超指数级狂飙,模型只需攻克极窄任务即可触发递归自我改进。更致命的是,大模型所有欺骗与失控行为全源于后训练强化学习,而业界至今无法摆脱这一死结。认清风险却戒不掉算力特权,这才是硅谷AI圈的残酷真相。
🔗 [对谈视频]:https://www.youtube.com/watch?v=UggJMQskOj8
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章
没有相关内容!
